

前 29 天,我們從 PPG 訊號一路研究到 baseline、LLM 洞察與評測。回頭看程式,卻發現中間有個斷點:PPG 只算到逐窗心率與品質,洞察服務則從既有的日資料開始,兩段還沒接上。
最後一天要把實際做出的系統畫清楚:誰算數字、誰選證據、誰負責解釋與檢查?失敗時能追查到哪裡,還有哪些判斷要交給人?這也是回答系列起點的問題:AI 能根據健康資料說到什麼程度?
今天整理既有程式與紀錄,不新增實驗或模型呼叫。Hands-on 用架構圖、責任表與 demo 核對成果,並整理知識地圖、技能清單與系列回顧。
這個系統有兩段。第一段從 PPG 算逐窗心率與品質;第二段從 LifeSnaps 日表或合成日資料,建立 personal baseline、判定偏離,再交給 LLM 解讀。兩段沒接上有兩個原因:repo 的 PPG-DaLiA S1、S2 各只有約 2.3–2.6 小時的白天紀錄,不足以建立跨日 baseline;feature contract 也沒有定義窗層級到日層級的銜接。這是目前資料與設計的限制,不代表原理上做不到。
資料往下傳時,日期、單位、品質與缺值狀態都要保留。尤其 decidable=false 表示無法判定,不能被解讀成「沒有偏離」。feature contract 約定這些欄位的意思與版本;模型只能根據實際收到的摘要說話,追查檔裡有的資料不等於模型也看過。
日資料後面又分成兩條路。Day 23 的 run 寫出 evidence bundle:7 天的 summary-v1 供模型使用,payload、trace、manifest 留作追查,本身不呼叫模型。Day 27 的 ask/endpoint 則重建 60 天的 summary-v2,選 context、呼叫模型並檢查輸出。它不寫 bundle,追查要另存 run 紀錄:CLI 加 --out,API 設定 record_dir。
baseline、偏離與跨指標標記交給確定性程式。同樣輸入可以重算,但不保證抓得到事件:Day 23 的合成生病情境,事件期最大 |z| 是 2.396,未達 3.0 門檻。context builder 負責依問題選證據、記錄省略內容;token 預算也只是估算,Day 27 四案估計都在 8,000 內,實際送出卻全部超過。
LLM 負責產生觀察、解讀、不確定性與下一步。前三者逐筆附引用,next_step 不進 checker。schema validator 查格式與引用是否合法;citation checker 再核對指標、數字、單位與日期。不可判定的指標、太籠統的引用或計數詞會留下人工判讀原因,計數詞本身不驗算。有確定性錯誤仍判 fail,沒有才是 needs_human。這些規則只能核對部分內容,不能保證整句話都有證據支持。
服務送出的只有摘要,追查用的 trace 與事件標籤不送;leak_check 另外擋情境名稱、路徑與 subject_id,但只比對字串。請求失敗會留下類別與 stage;要知道停在哪裡,得看 stage,因為 internal 錯誤可能出現在任一階段。服務回 ok,也只代表四層驗證通過、checker 沒有 fail;needs_human 只回報筆數,並未自動完成人工審查。
離線 evalcheck 持有測例的期望答案,不在服務路徑。評測結果也會變動:預設 prompt-v2在 Day 26 的 pass 數領先 v1(16/27 對 8/27),Day 28 同九個測例縮成 8/27 對 6/27。這支持的是特定測例與規則下的表現,不能當成健康判斷準確率。Day 29 的 safety policy 也尚未接進服務,極端值只測一種資料觸發情境,逐句判讀仍待人工確認。
在這個 prototype 裡,我們能檢查的是:回答有沒有對上模型看到的資料、是否保留「無法判定」、引用是否支持主張。前兩項已有部分程式檢查;完整句意仍需人判讀。Day 24 的引用支持標註由 agent 完成,20 列抽查也是同一 agent 的非盲重標,不能當人工真值。模型對摘要的解讀,無法證明量測正確,也不能從偏離推出病因或診斷。安全政策、資料最小化與人工判讀,仍有尚未落實的部分。
回顧技能,也可以沿著這條責任鏈整理:訊號端是載入、濾波、取樣與抗混疊、找峰、HRV 和品質判定;日資料端是時間對齊、缺值、多表整合、帶 seed 的事件模擬、群體與個人分布、baseline、偏離評估和版本化 schema;LLM 端是 API 與紀錄保存、prompt、structured output、grounding、context、回歸評測和服務接線。每項都要分清楚:已有程式與測例,還是只有政策或待人工確認的結果。
今天沒有新實驗,做的是盤點:把 Day 23–29 的程式和已存紀錄逐一對照,確認每個元件實際吃什麼、交出什麼、在哪裡會停下。分三步:
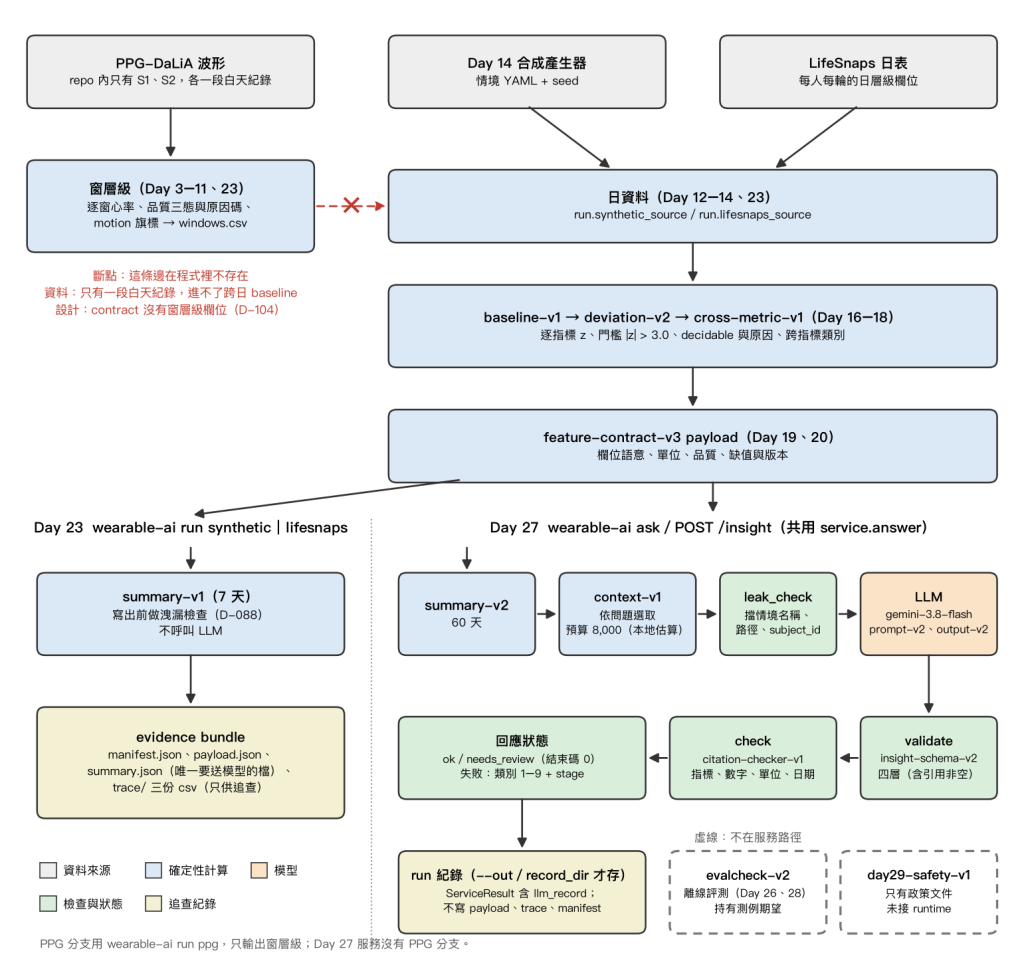
圖:兩個入口共用到 feature contract。PPG 只到窗層級(✕);虛線的 evalcheck-v2 與 day29-safety-v1 不在服務路徑。
服務把失敗分成 9 類,各有結束碼,表中括號就是這個元件會丟出的那幾類;另外記錄停在哪個階段。
| 元件 | 負責 | 輸出或擋下 | 缺口 |
|---|---|---|---|
訊號層(run.ppg_windows) |
逐窗心率、品質三態、motion | windows.csv |
不進日資料 |
日資料(run.synthetic_source、lifesnaps_source) |
對齊、缺值、配戴 | 日層級表 | 日值不是從波形算出 |
baseline、anomaly |
baseline、z、decidable、跨指標類別 |
trace | 不保證敏感 |
ai.contract |
欄位語意、單位、品質、版本 | payload(4) | 沒有窗層級欄位 |
ai.summary、ai.context |
依問題選欄位、估預算 | summary-v2(9) |
預算是本地估算 |
leak_check |
擋情境名稱、路徑、subject_id |
(5) | 只比對字串 |
ai.llm |
生成四類內容 | 回應(6、7) | 重新生成不保證相同 |
ai.grounding |
結構驗證、citation checker | ok/needs_review(8) |
句意沒有人核對 |
ai.evalcheck |
離線回歸 | pass/needs_human/fail | 不在服務路徑 |
safety_policy.md |
醫療邊界、資料最小化 | 人工複核標準 | 沒有對應程式 |
uv run wearable-ai run synthetic --scenario suspected_illness --person p01 \
  --date 2026-03-05 --out /tmp/bundle
uv run wearable-ai ask synthetic --scenario suspected_illness --person p01 \
  --date 2026-03-05 --question vs_baseline --dry-run
run: payload、summary 與三份 trace 和 Day 23 的存檔逐位元相同;manifest 只差 code.commit、code.dirty。ask --dry-run: 停在 leak_check,估計 7,885 tokens、在預算內,省略較舊的逐日列 46 列。repo 裡的 demo 說明把兩條路徑分開寫,各自交代:
uv sync;合成情境不用下載;LifeSnaps、PPG-DaLiA 要自行下載;真的呼叫模型才需要 API key。run 寫出 6 個檔,和存檔比對;ask 回 ok 或 needs_review,失敗時回類別與停下的階段。ok 只代表驗證通過、checker 沒有 fail,不代表回答經過人工審查。知識地圖也照同一個原則改:PPG 那條鏈到逐窗結果就停,R-R 與 HRV、夜間指標改標成 Phase 1 的探索支線;合成事件的真值只連到評估,不連到偏離偵測。
| 原本以為 | 實際發現 |
|---|---|
| 以為 PPG 算出的心率與 HRV,會接進日資料與 personal baseline。 | 照程式畫,PPG 到日資料那條邊不存在;Phase 1 的程式只到窗層級,日層級的 rmssd、resting_hr 來自 LifeSnaps 日表或合成產生器。 |
| 以為 Day 27 會直接讀 Day 23 的 bundle,也用同一組檔案追查。 | 系統有兩個入口,共用到 feature contract 為止。evidence bundle 只在 Day 23 的 run;Day 27 的服務不寫 payload、trace、manifest,追查靠另存的 run 紀錄(--out/record_dir 才存)。 |
| 以為固定情境與 seed,整條 demo 就能重跑出相同結果。 | 決定性的前段可以逐位元重現:2026-10-13 重跑 Day 23 的合成 bundle,五個檔和存檔相同,manifest 只差 code.commit 與 code.dirty。模型重新生成的結果不保證相同;存下的回應可以用同版 validator 與 checker 重放。 |
| 以為 Day 26 的評測與 Day 29 的 safety policy,已接進服務。 | 服務收到請求時執行的檢查只有 leak_check、四層結構驗證與 citation checker;評測與 safety policy 都在服務之外,Day 29 的 policy 沒有對應程式。 |
以為標上 needs_human 的句子,已有人工確認可供評測。 |
Day 24、26、29 三天的逐句判讀共 534 列,全部是 agent 標註或預審,人工確認 0 列(168、312、54 列)。系統留了 needs_human,但人還沒有接上。 |
| 以為整理日資料、算 baseline 和選 context,會占去不少請求時間。 | 服務一次請求的時間幾乎都在模型:Day 27 的 12 次,模型呼叫佔七階段合計的 97.3–99.4%,送出前四個階段中位數 0.242 s。 |
今天盤點的是 2026-10-13 的程式與既有紀錄,重跑 demo 並未重新驗證整條鏈。PPG 到日資料的橋接仍未實作或測試,波形端的結果不能替洞察服務的輸入品質背書。離線評測與 safety policy 尚未接進服務,資料最小化也只做了盤點;另存的 run 紀錄仍含完整輸入與輸出。demo 沒有部署、認證或併發控制。
資料與判讀也有侷限:PPG 只有 S1、S2 的短時段紀錄,服務與回歸測例主要用合成日資料,模型只測 gemini-3.8-flash 在指定情境、prompt 與檢查規則下的輸出。Day 24、26、29 共 534 列逐句判讀全由 agent 標註或預審,人工確認為零,不能估計 checker 的語意正確率或醫療安全性。偵測結果與服務的 ok,也不能外推到真實穿戴資料、其他模型或臨床判斷。
第一,架構圖是一份可以核對的聲明。每條箭頭都該對到一個函式或一個檔案;對不到的地方畫成斷點,比畫成連續有用。照 TOPIC_PLAN 的直線讀,會以為這個系統從腕上波形一路算到建議;照程式畫,它其實是兩段:一段處理波形品質,一段從 LifeSnaps 日表或合成產生器的日值開始。後一段的結論不能回頭替前一段背書。
第二,每一層保證的事要寫窄。確定性程式保證可重現,不保證抓得到事件;context 的預算是本地估算,不是供應端計數;pass 只代表結構符合,ok 只代表驗證通過、checker 沒有 fail。責任表的「目前缺口」那一欄,就是把這些保證的邊界寫出來;少了它,每一個綠燈都會被讀成比實際更強的意思。
第三,可重現有兩種。模型之前的部分,在固定程式、資料與環境下可以重跑出相同結果(本例的 payload、summary 與三份 trace 逐位元相同,manifest 與耗時這類執行資訊除外),壞了可以拿 trace 一層層追;模型重新生成時,只能固定輸入與設定、重複呼叫看分布;回應存下來後,validator 與 checker 可以用同一版本重放。Day 28 同一格測例三輪的裁決就會不同;Day 26 到 Day 28 同一批測例的 pass 數也變了,那次還差了呼叫日與 max_output_tokens。這是這一段的性質,回歸表因此要列分母、呼叫日與設定。
最後回到系列起點的問題。在這個 prototype 裡,模型能依據的是送進去的 summary:日期、數值、單位、品質、baseline 狀態與偏離判定,檢查也只能核對它有沒有說到這些、引得對不對。它不能從這些資料推出量測是否正確、偏離的原因或診斷;這些判斷在架構上屬於人,而目前人的那一格還是空的。


 iThome鐵人賽
 看影片追技術